Robots.txt : à quoi sert ce fichier et pourquoi l’IA change la donne ?
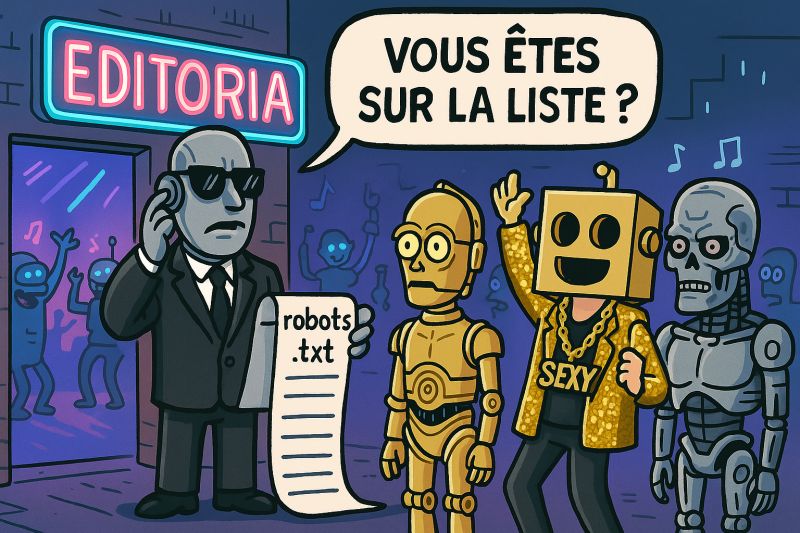
En 1994, Le Roi Lion sort au cinéma, IAM fait danser la France avec « Je danse le Mia » et Internet commence à se démocratiser. C’est aussi l’époque où apparaît un petit fichier texte devenu un enjeu majeur pour les éditeurs : robots.txt. Trente ans plus tard, l’arrivée des moteurs de réponse et des IA génératives lui donne une nouvelle importance.
Le fichier robots.txt indique aux robots d’exploration quels chemins d’un site ils sont autorisés à parcourir. Placé à la racine du domaine, il utilise notamment les directives User-agent, Disallow et Allow. Il s’agit d’un protocole de coopération, pas d’un dispositif de sécurité. Pour les éditeurs, il est devenu un outil de gestion des accès des robots de recherche et des services d’IA, avec des arbitrages entre visibilité, trafic, contrôle et rémunération.
1994 : pourquoi a-t-on inventé robots.txt ?
Aux débuts du Web, les moteurs de recherche utilisent des crawlers, des logiciels qui parcourent automatiquement les pages pour découvrir et indexer des contenus. Sur des infrastructures modestes et des connexions lentes, des explorations trop intensives pouvaient surcharger les serveurs ou aspirer de nombreuses pages.
Le Robots Exclusion Protocol est proposé en 1994 par Martijn Koster. Son principe : laisser chaque site publier des consignes de parcours compréhensibles par les robots coopératifs. Il ne garantit toutefois ni la confidentialité ni la protection contre une extraction non autorisée.
Comment fonctionne robots.txt ?
Un fichier robots.txt est un fichier texte public situé à la racine d’un hôte, par exemple lefigaro.fr/robots.txt. Un crawler qui respecte ce protocole consulte les règles pertinentes avant d’explorer les URL du site.
| Directive | Rôle | Exemple |
|---|---|---|
User-agent | Identifie le robot ou le groupe de robots concerné. | User-agent: * |
Disallow | Indique les chemins que le robot ne doit pas explorer. | Disallow: /prive/ |
Allow | Autorise explicitement un chemin, notamment comme exception à une règle plus générale pour les robots qui la prennent en charge. | Allow: /prive/public/ |
Un exemple simple de fichier robots.txt
User-agent: *
Disallow: /espace-interne/
Allow: /

Sitemap: https://exemple.fr/sitemap.xml
Dans cet exemple, les robots coopératifs peuvent parcourir le site, sauf les URL sous /espace-interne/. La ligne Sitemap indique où trouver le plan du site. Attention : interdire l’exploration d’une URL ne la rend pas privée et ne garantit pas sa disparition des résultats de recherche.
Robots.txt est-il une protection contre les robots malveillants ?
Non. Les règles robots.txt sont publiques et leur respect dépend du robot. Un acteur malveillant peut les ignorer. Pour protéger réellement une ressource, il faut recourir à des mesures adaptées : authentification, autorisations côté serveur, limitation des requêtes ou autres contrôles techniques.
Le fichier n’est pas non plus un bouton universel « interdire l’utilisation de mes contenus pour entraîner une IA ». Les conséquences techniques et juridiques dépendent des usages, des contrats, des règles applicables et du comportement de chaque opérateur. Un robots.txt n’équivaut pas à lui seul à une décision juridique sur tous les droits d’utilisation des contenus.
Pourquoi robots.txt devient-il stratégique face aux IA génératives ?
Pour les éditeurs, la question ne concerne plus seulement l’indexation par les moteurs de recherche. Les contenus peuvent également être explorés pour alimenter des systèmes d’IA, des fonctionnalités de recherche ou des services de réponse. Ces usages sont distincts et peuvent être associés à des robots ou à des mécanismes de contrôle différents.
Le dilemme évoqué dans le post original de GreyFox Ads est simple : autoriser l’exploration peut soutenir la découverte et la visibilité, tandis que la restreindre peut renforcer le contrôle sur les contenus, mais éventuellement limiter certaines sources de trafic. Aucun des deux choix ne garantit à lui seul des visites ou une rémunération.
| Choix éditorial | Intérêt possible | Point de vigilance |
|---|---|---|
| Autoriser les robots de recherche | Faciliter la découverte des articles. | L’indexation ne garantit pas le clic vers l’éditeur. |
| Restreindre certains robots liés à l’IA | Exprimer une politique de contrôle de l’exploration. | Les règles et les catégories de robots varient selon les opérateurs. |
| Différencier les usages | Adapter la politique au type d’exploration et aux objectifs de distribution. | Nécessite une veille et des vérifications régulières. |
Pour les règles propres à OpenAI, consulter la documentation officielle des robots OpenAI. Pour les moteurs de recherche, consulter la documentation Google Search Central. Les noms de robots, leurs fonctions et les modalités de contrôle sont susceptibles d’évoluer.
Quelle stratégie robots.txt pour un éditeur de l’Open Web ?
- Identifier les objectifs : référencement, trafic direct, contrôle de l’extraction, éventuelles négociations de licence.
- Auditer les robots : analyser les journaux serveur, sans confondre user-agent déclaré et identité vérifiée.
- Segmenter les règles : distinguer les robots et usages quand les opérateurs le permettent.
- Vérifier l’impact SEO : éviter de bloquer accidentellement des contenus importants pour les moteurs.
- Ne pas confondre exploration et protection : sécuriser séparément les contenus privés.
- Réévaluer régulièrement : les politiques des opérateurs et les usages de l’IA évoluent rapidement.
Cette réflexion rejoint une question plus large : comment financer durablement les contenus de l’Open Web à l’ère des plateformes ? Et, côté monétisation publicitaire, comment réduire la dépendance des éditeurs aux plateformes sociales ?
Et GreyFox Ads dans tout ça ?
Chez GreyFox Ads, nous ne commercialisons pas de solution de gestion des robots d’IA. Notre métier est d’aider les Media Traders à investir plus efficacement sur un Open Web de qualité grâce à des Curated Master Deals : sélection de chemins d’achat pertinents, exclusion des sites MFA, brand safety, formats offrant une meilleure présence à l’écran et ciblage adapté aux signaux disponibles, dans le respect des autorisations applicables.
Le point commun entre robots.txt et curation ? Reprendre le contrôle sur la valeur produite par les éditeurs — sur le plan de la distribution des contenus comme sur celui de la publicité.
Conclusion
Un fichier de quelques lignes, inventé à l’aube du Web, se retrouve aujourd’hui au cœur d’un débat stratégique : qui peut explorer les contenus des éditeurs, pour quel usage et en échange de quelle valeur ? Le robots.txt n’apporte pas toutes les réponses, mais il reste l’un des premiers outils à comprendre.
Sources et périmètre
Post d’origine : publication LinkedIn GreyFox Ads sur les robots.txt. Cet article développe le raisonnement du post, avec des précisions techniques et des nuances sur la sécurité et les usages des robots IA.
Références techniques : RFC 9309 — Robots Exclusion Protocol ; Google Search Central ; documentation des robots OpenAI. Les politiques des robots et les effets juridiques doivent être vérifiés au cas par cas.
Vous souhaitez mieux valoriser vos investissements sur l’Open Web ?
Échangeons sur vos objectifs de qualité, de transparence et d’efficacité programmatique.